
6月11日下午,在崇德楼501会议室举办了一场关于语言大模型(LLM)原理与应用的学术讲座。本次讲座由浙江省服务机器人重点实验室副主任顾静军博士、高级工程师主讲,信息工程学院院长陈红岩教授主持,吸引了众多师生前来聆听。
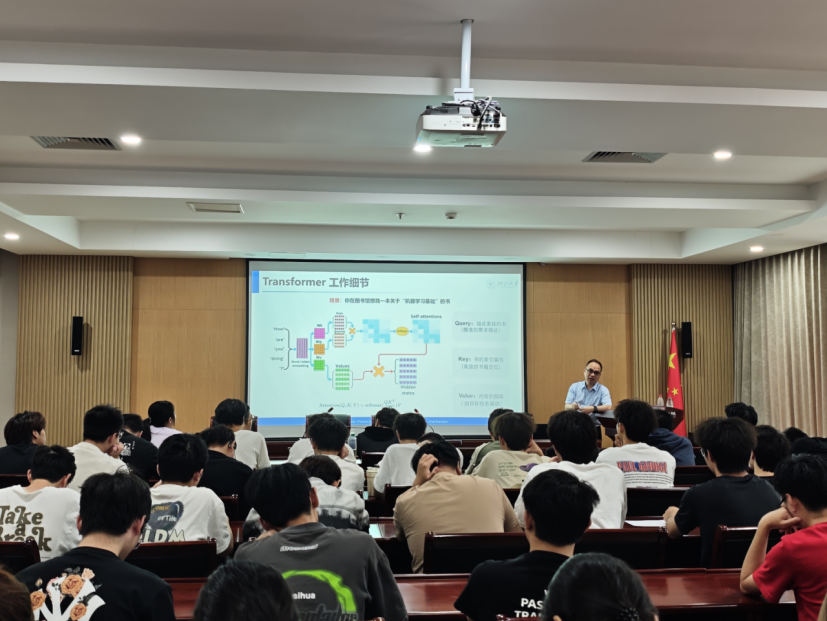
讲座伊始,顾博士对语言大模型的发展历程进行了系统地梳理。从早期的基于统计的N-gram模型,到基于神经网络的LSTM/GRU模型,再到2017年后Transformer架构的出现,语言模型在技术上实现了质的飞跃。Transformer架构凭借其强大的并行计算能力和全局上下文理解能力,成为语言大模型的技术基座。顾博士详细介绍了Transformer架构中的自注意力机制、多头注意力机制以及前馈网络、位置编码和层归一化等关键技术,这些技术突破了传统模型的诸多局限性,推动了语言模型的快速发展。
在语言模型的基本任务方面,顾博士指出,编码是让计算机理解人类语言的关键。他对比了独热编码和词嵌入两种编码方式。独热编码虽然简单直观,但在处理大规模类别数据时存在维度爆炸、信息冗余等问题;而词嵌入通过低维连续向量表示词语,能够有效解决这些问题,并且使得语义或语法相似的词在向量空间中距离接近,为下游任务如文本分类、机器翻译等提供了强大的支持。
随后,顾博士深入探讨了大型语言模型的发展简史和技术演进。从2017年的Transformer模型,到2018年的BERT模型,再到2019年的GPT-2模型,以及2020年之后的GPT-3、T5、LLaMA等模型,语言大模型的参数规模不断增大,性能不断提升。特别是GPT-3模型,其1750亿参数的规模和强大的涌现能力,标志着语言模型发展的一个重要转折点。顾博士还提到了OpenAI的GPT系列模型的最新进展,如GPT-3.5系列、GPT-4系列,以及DeepSeek模型的出现,这些模型在推理能力、多模态能力、专属能力等方面都有显著提升,为语言大模型的应用拓展了更广阔的空间。
在语言大模型的应用方面,顾博士列举了多个领域和场景。在教育领域,语言大模型可以辅助教学,生成教学内容,提供个性化的学习建议;在医疗领域,语言大模型可以用于医学影像分析、疾病诊断辅助、医疗文献解读等;在法律领域,语言大模型可以协助法律文书撰写、案例分析、法律咨询等;在智能制造领域,语言大模型可以实现智能问答、报告生成、审核与合规、知识管理等功能,提升企业的运营效率和创新能力。顾博士还特别提到了DeepSeek模型在推理大模型上的优势,以及其在不同硬件配置下的部署成本和适用场景,展示了语言大模型在实际应用中的灵活性和可扩展性。
最后,顾博士对语言大模型的未来发展趋势进行了展望。他认为,随着技术的不断进步和应用场景的不断拓展,语言大模型将在更多领域发挥重要作用。同时,他也提醒大家关注语言大模型在数据安全、隐私保护、伦理道德等方面可能带来的挑战,呼吁学术界和产业界共同努力,推动语言大模型的健康发展。
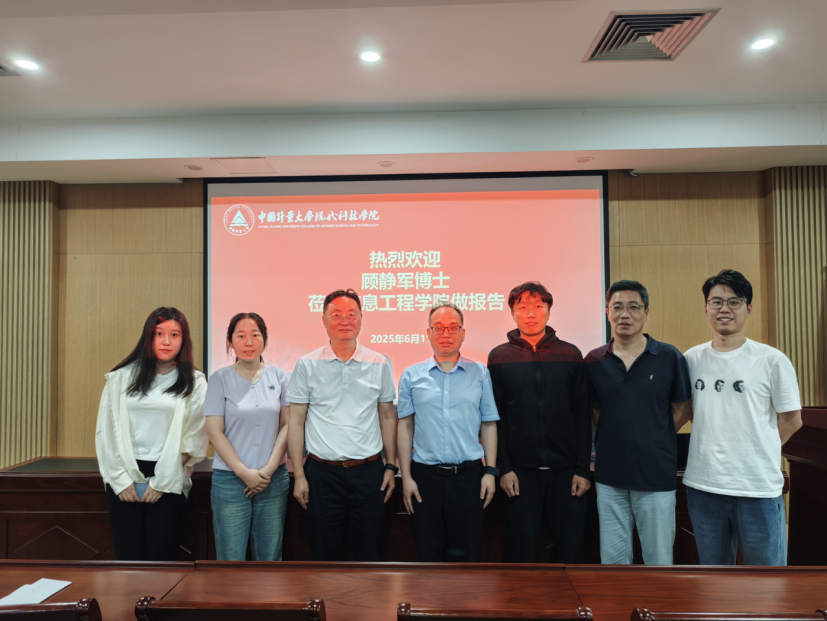
本次讲座用时2个多小时,内容丰富,深入浅出,不仅让在场师生对语言大模型的原理有了更深刻的理解,也为大家展示了语言大模型在各个领域的广泛应用前景。讲座结束后,顾博士还与现场师生进行了互动交流,回答了大家的提问,进一步激发了大家对语言大模型研究和应用的兴趣。
